
Kinect의 SimpleOpenNI API 사용하기
기본적인 튜토리얼로 이것으로 시작하였으려나, 사용하려는 데모 튜토리얼은 이게 더 멋있어서 바꿔 진행했다.
허나 문제는 이 튜토리얼은 Kinect v1만 지원한다는 것인데, Kinect v2를 지원하는 지는 더 알아봐야할 문제이다. 이 튜토리얼은 SimpleOpenNI를 적극적으로 활용하는데, Processing을 이용해서 이 라이브러리를 어떻게 사용하는지를 짧게 옮겨본다.
가장 기본적인 코드는 다음과 같다.
// Kinect Basic Example by Amnon Owed (15/09/12)

// import library
import SimpleOpenNI.*;
// declare SimpleOpenNI object
SimpleOpenNI context;
// PImage to hold incoming imagery
PImage cam;

void setup() {
  // same as Kinect dimensions
  size(1280, 480);
  // initialize SimpleOpenNI object
  context = new SimpleOpenNI(this);
  context.setMirror(true);

  if (!context.enableDepth() || !context.enableUser()) {
    // if context.enableScene() returns false
    // then the Kinect is not working correctly
    // make sure the green light is blinking

    println("Kinect not connected!");
    exit();
  }
}

void draw() {
  // update the SimpleOpenNI object
  context.update();
  // put the image into a PImage
  // display the image
  image(context.userImage(), 0, 0);
  image(context.depthImage(),640,0);
}
내가 사용하는 Processing, SimpleOpenNI등의 환경은 과거에 쓴 글을 참고하면 된다. 가장 중요한 부분은 코드를 튜토리얼과 다르게 수정한 몇 부분이다. 차례차례 설명을 해보자면
// import library
import SimpleOpenNI.*;
// declare SimpleOpenNI object
SimpleOpenNI context;
// PImage to hold incoming imagery
PImage cam;
SimpleOpenNI 라이브러리를 불러들이고, 그 라이브러리를 활용할 context라는 객체를 담을 변수를 선언한다.. cam이라는 PImage의 쉽게말해서, 어떤 이미지를 갖고있을 수 있는 변수를 선언한다. 나는 이 cam이라는 변수를 사용하지 않지만 기호에 따라서 사용할 수 있다.
void setup() {
  // same as Kinect dimensions
  size(1280, 480);
  // initialize SimpleOpenNI object
  context = new SimpleOpenNI(this);
  context.setMirror(true);

  if (!context.enableDepth() || !context.enableUser()) {
    // if context.enableScene() returns false
    // then the Kinect is not working correctly
    // make sure the green light is blinking

    println("Kinect not connected!");
    exit();
  }
}
setup이라는 함수를 통해서 kinect가 설정되도록 한다. 가로 1280, 세로 480 사이즈의 윈도우를 사용한다. 본래는 640,480으로 설정하지만 나는 영상 두개를 동시에 출력하기 위해서 가로를 1280으로 해주었다. 아까 선언해둔 context 변수에 SimpleOpenNI 객체를 담는다. 그리고 이 context를 계속 활용해서 kinect가 인식하고 있는 영상을 실시간으로 전송받을 것이다. setMirror 함수로 거울상에 보는 것처럼 좌우 반전시킨다. 옛날 코드는 context.setMirror(true)함수가 if (!context.enableDepth() || !context.enableUser()) { 다음에 else 부분에서 선언되어 있었는데, 내가 사용하고 있는 버전에서는 context.enableUser() 후에는 setMirror가 안된다. 그래서 그냥 그전에 미리 좌우 반전시켜준다. 그리고 만약에 Depth, User Image를 하나라도 받지 못한다면 Kinect가 연결되지 않은것이라 간주하고 **"Kinect not connected!"**를 출력하고 종료한다.
이제 받은 영상을 모니터에 그려주는 작업을 하자.
void draw() {
  // update the SimpleOpenNI object
  context.update();
  // put the image into a PImage
  // display the image
  image(context.userImage(), 0, 0);
  image(context.depthImage(),640,0);
}
context.update()를 통해 계속 context가 받는 이미지를 업데이트한다. 그리고 화면의 (0,0)좌표에는 context의 userImage를 그리고, (640,0)에는 depthImage를 그려준다. 여기서 (0,0)은 화면 왼쪽상단을 의미하며, 오른쪽으로 갈수록, 아래쪽으로 내려갈수록 각 좌표값이 커진다.
따라서 그려지는 그림은 다음과 같다.
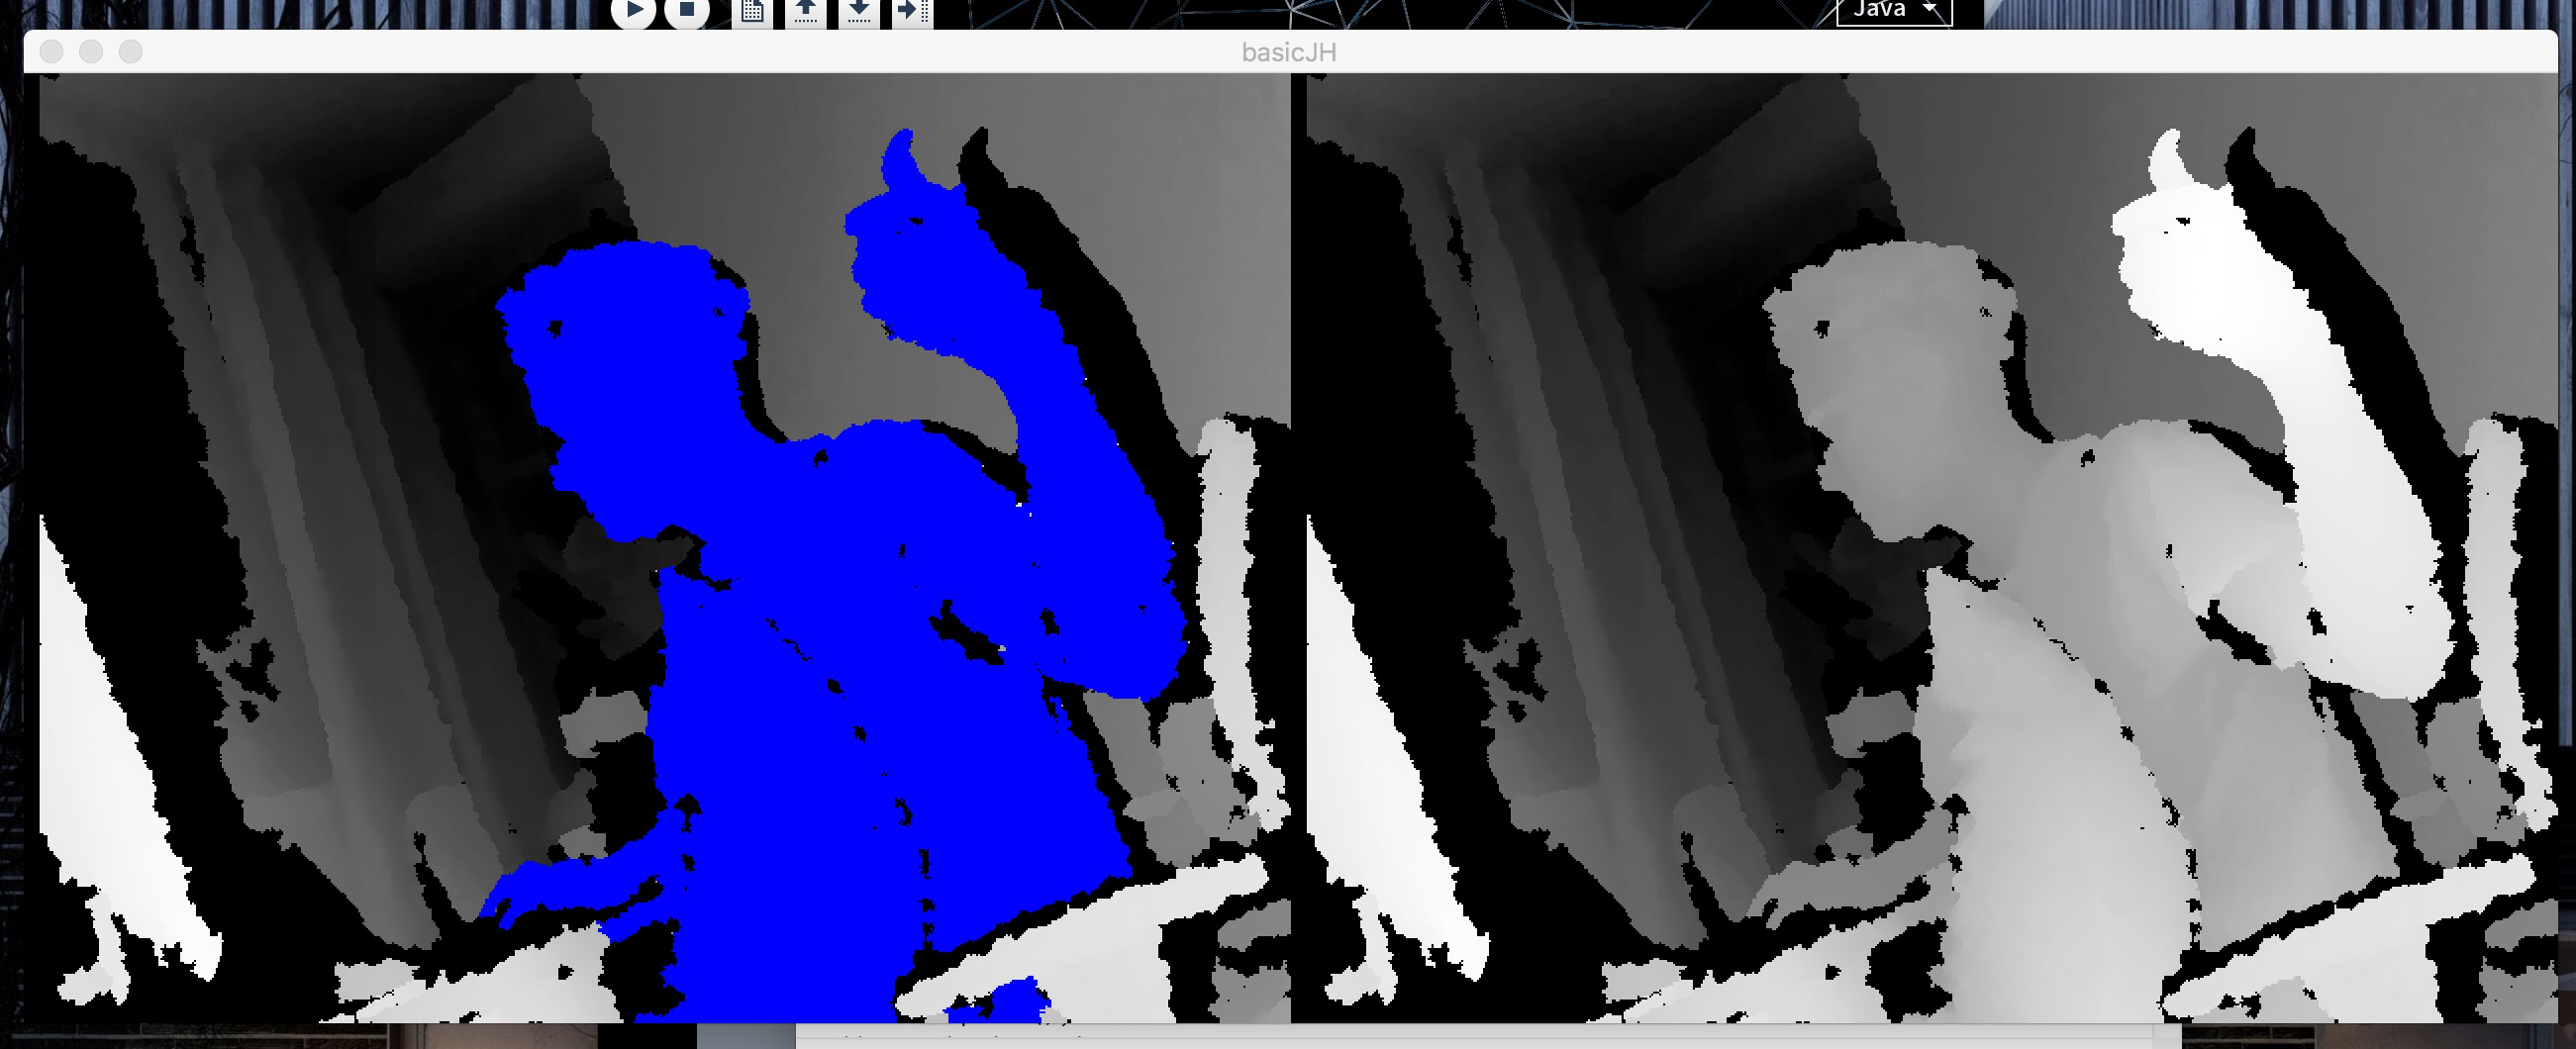
그려보고 나니 userImage와 depthImage는 별반 차이가 없지만, user, 즉 사람이 보이는 듯하면 파란색 skeleton으로 인식해준다. 만약 근거리에 사람같은게 없다면 둘의 차이는 없다.
만약 처음에 PImage타입으로 선언해둔 cam 변수를 적절히 사용하고 싶다면
cam = context.userImage();
image(cam, 0, 0);
cam = context.depthImage();
image(cam, 640,0);
이렇게도 할 수 있을 것이다.
이게 제일 기초적인 kinect를 사용하기 되는 code이다.
이 내용을 충분히 이해한다면 다음 영상을 출력해보자.
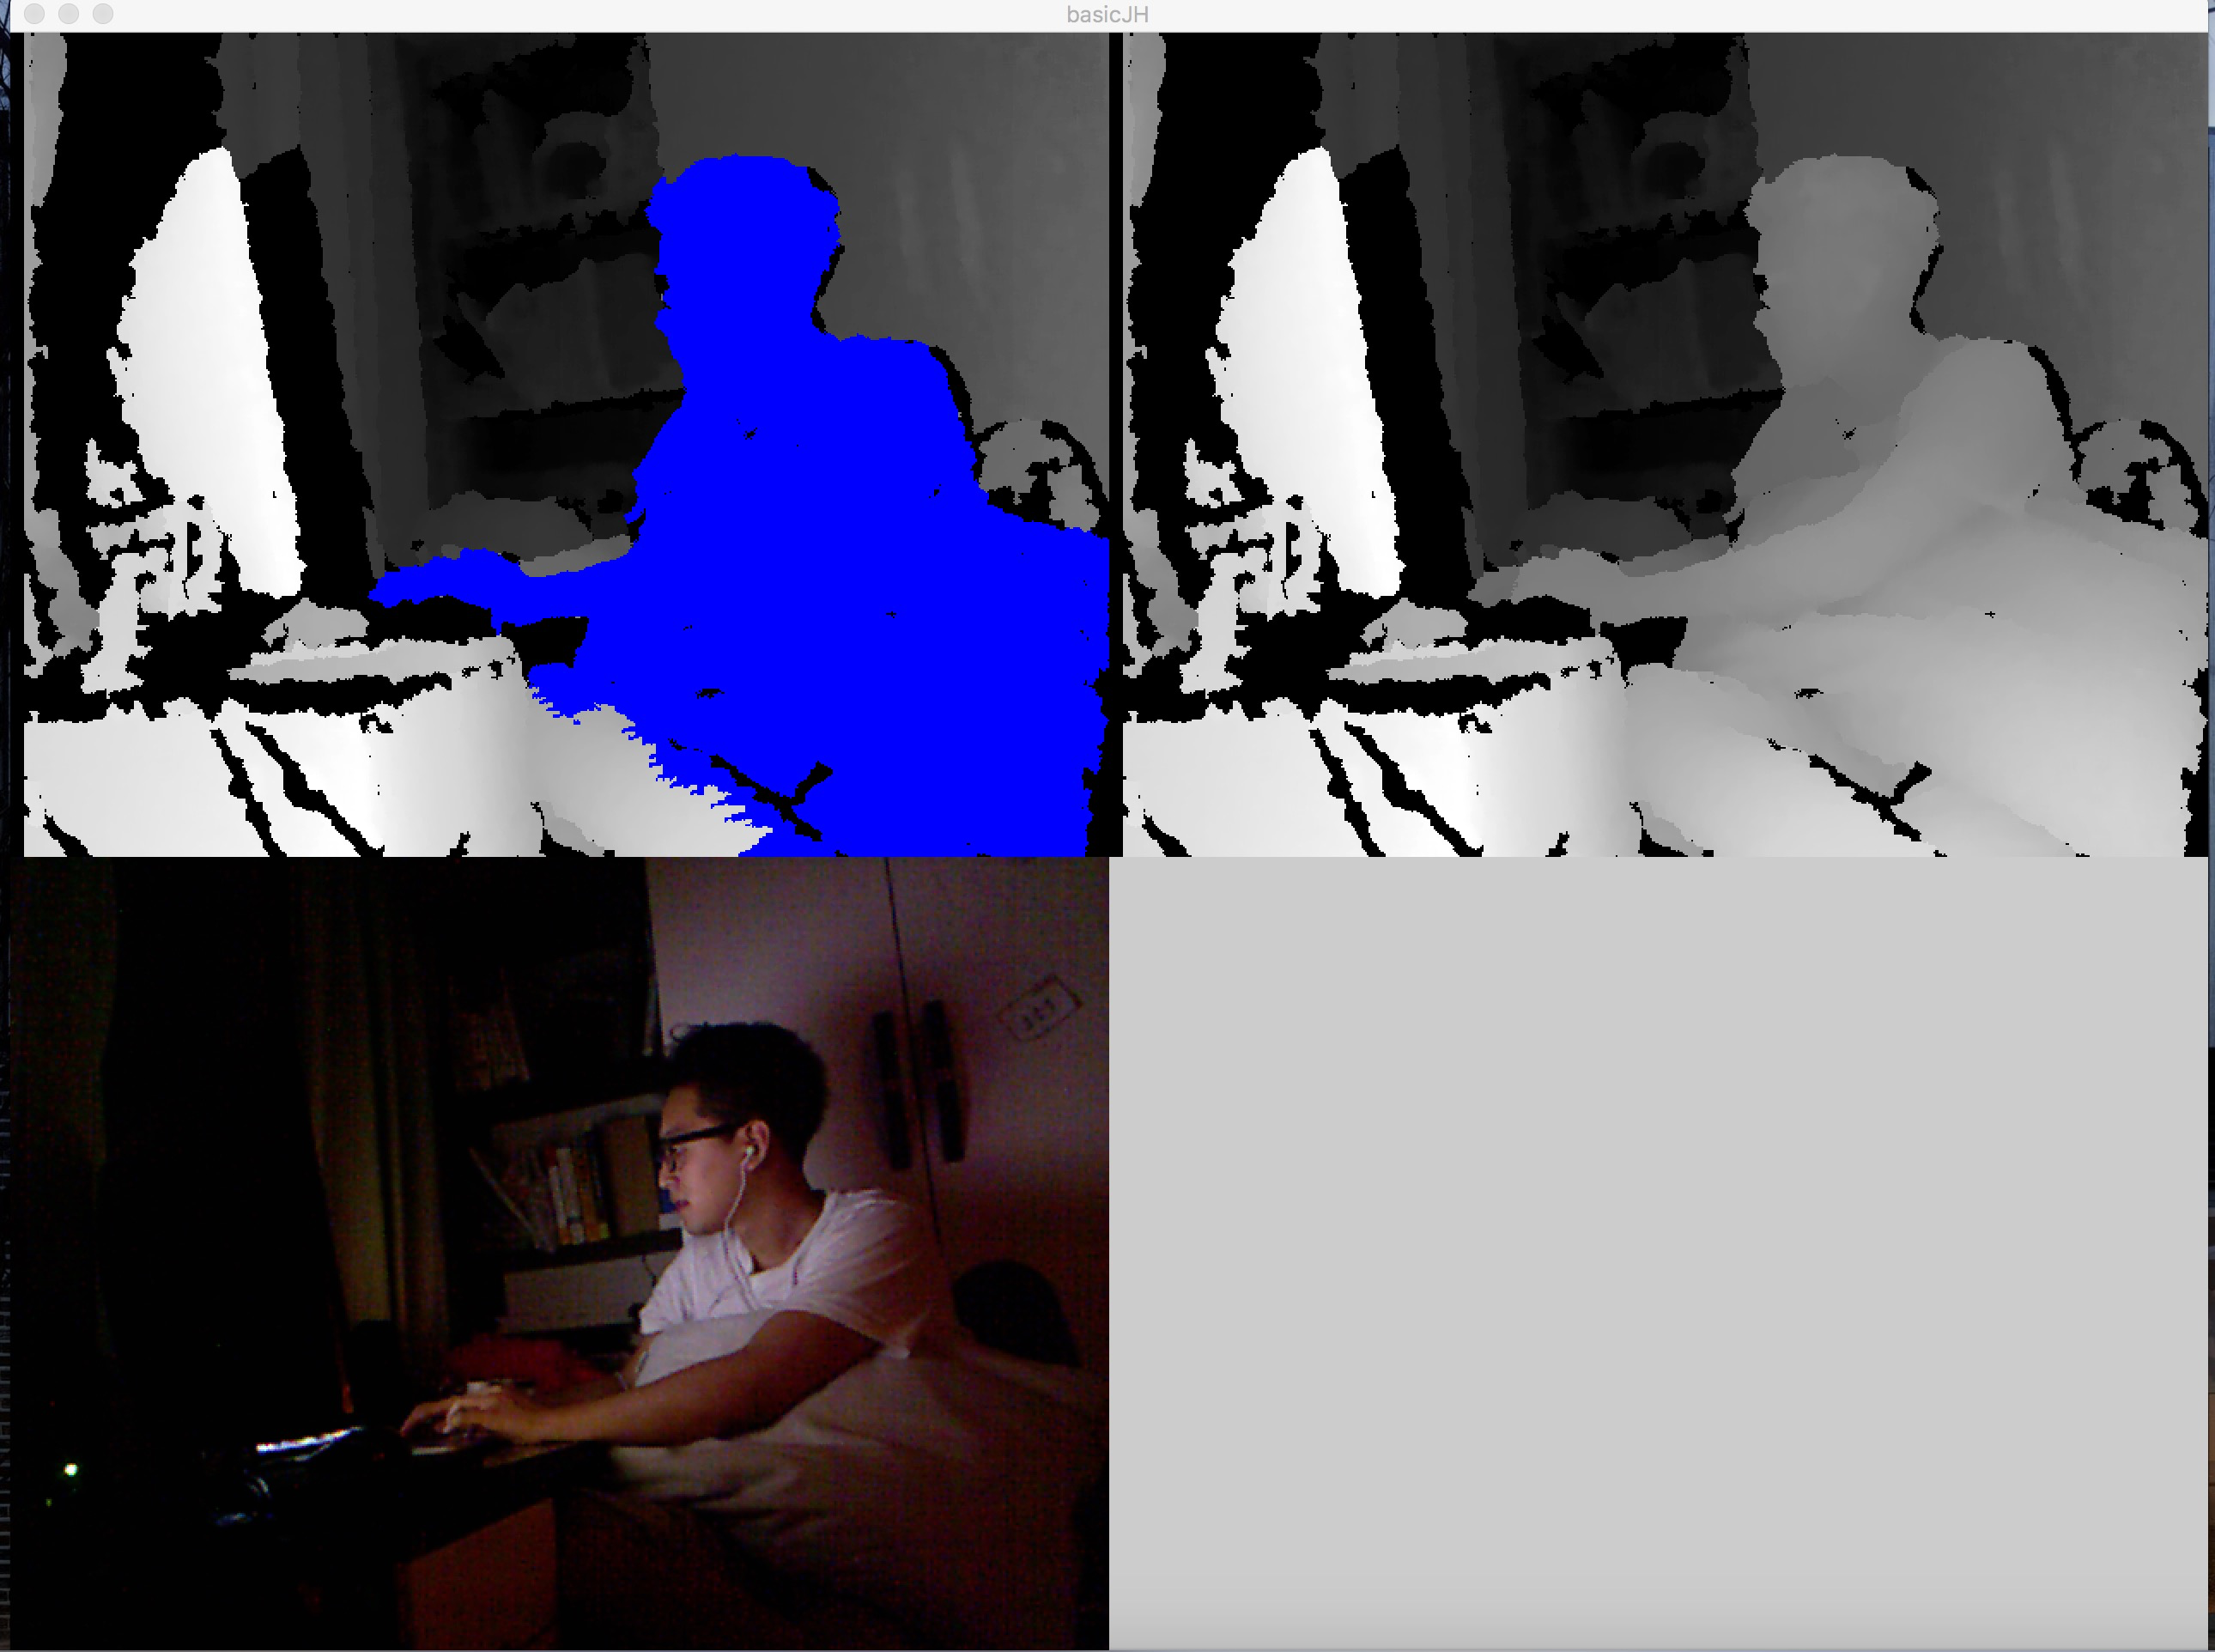
추가로 사용하는 라이브러리 함수는 enableRGB, rgbImage이다.


