Kinect v1와 v2. 그리고 OSX, 맥에 연결시키기

Share
Kinect v1와 v2. 그리고 OSX, 맥에 연결시키기
Kinect v1

Kinect v2

둘의 자세한 비교는 이곳 블로그에 잘 소개되어있다.

두개 다 성공적으로 연결시킬 수 있었는데, 확실히 v2가 더 성능이 좋았다.
보통 윈도우에 연결시키는 후기들은 많아서 윈도우, 키넥트 둘다 MS꺼니까 나는 맥북프로를 쓰기 때문에 이걸 시도해봤다. 내가 쓰는 맥북프로는 OSX Elcapitan v10.11.3에서 테스트했다.
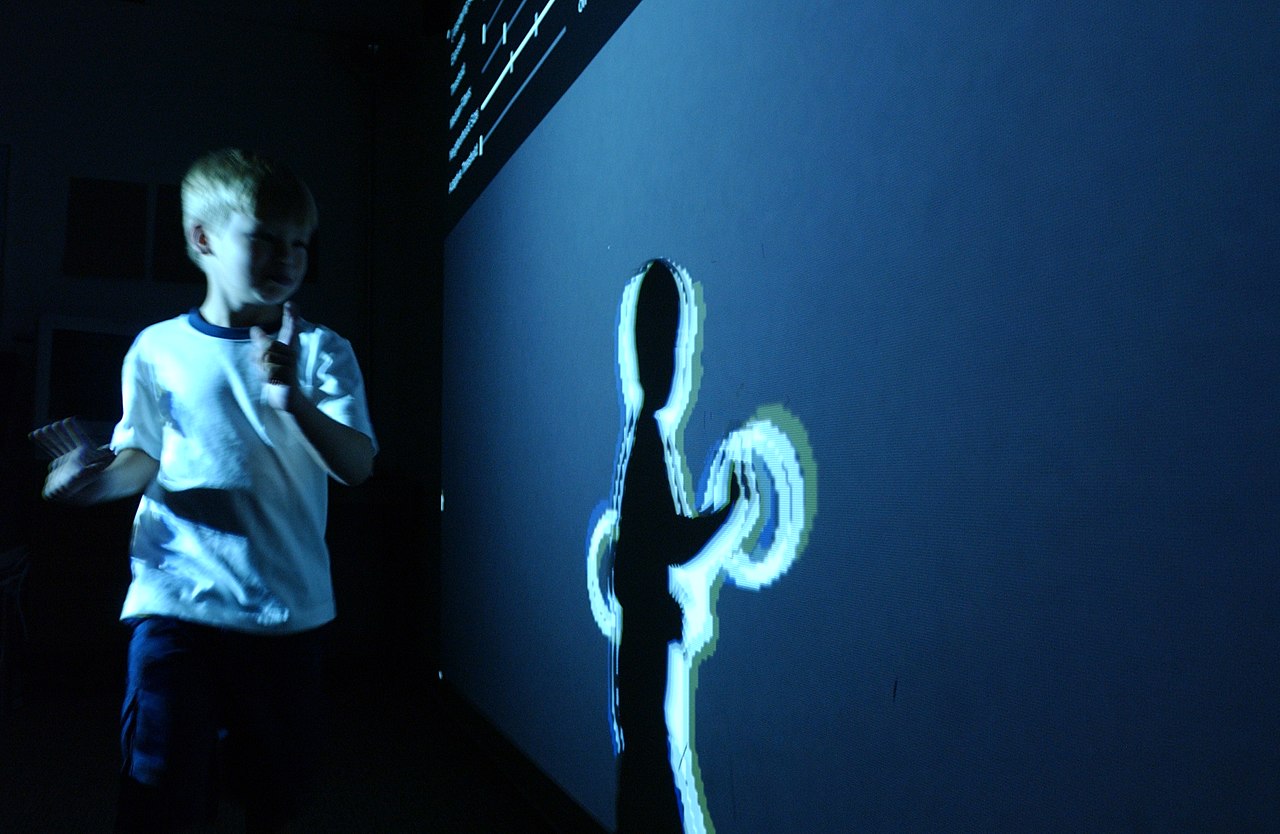
TEDxSNU의 Interactive Session같은 거로 다음 같은 걸 기획하려한다.

결국 이걸 하려면 Kinect를 맥에 연결시켜야한다. 일단은 연결시켜서 depth 측정이 동작되는지만 테스트중이다.
필요한 것.

  • Processing: 최신버전 말고 밑에 2.2.1을 설치함.
  • OpenNI-MacOSX-x64-2.2 을 설치한다.
  • 근데 OpenNI가 Apple로 인수되고 구버전이되면서 구하기가 힘들다.
  • 나는 지인에게 구했는데, OpenNI-MacOSX-x64-2.2.0.33.tar.bz2로 압축되어있었고 이걸로 될지도 모르겠다
  • 이거 설치는 terminal상에서 폴더로 들어가서 ./install.sh 정 모르겠다면 압축푼 폴더를 OpenNI-MacOSX-x64-2.2라 하고 다운로드 폴더에 저장해 뒀다면, 터미널을 켜고 ./Download/OpenNI-MacOSX-x64-2.2/install.sh 를 치자.

그리고 나머지 라이브러리는 Processing을 키고

상단 바에 Sketch > Import Library ... > Add Library에서 원하는 라이브러리를 찾아 검색하자. 나는 SimpleOpenNI와 openkinect_processing부터 설치했다.
기타 라이브러리를 구했다면 맥상에서 home/도큐멘트/Processing/libraries에 저장하면 된다. 그리고 Processing을 껐다 키기.

테스트는 Documents/Processing/libraries/openkinect_processing/examples/Kinect_v1 폴더 안에 AveragePointTracking.pde 등 아무거나 열면 Processing이 작동하면서 실행해볼 수 있다.
그러면 왠만하면 되는데 만약 library등이 설치가 안됬다는 둥 에러로그가 보이면 아까 설명한대로 설치하라는걸 설치하자.

Drawing 내 환경에선 Done. 이 후로는 [이런걸](https://github.com/genekogan/KinectProjectorToolkit)해보면서 kinect 통해서 프로젝터와 키넥트를 함께 calibration 시켜서 ![](/content/images/2016/01/kinect_example.png) 이렇게 벽에 mapping을 시키고 유저와 interaction이 가능한 미디어 아트를 구현해보면서 과정을 공유할 예정이다. 끝.

Read more

허깅페이스 르로봇 해커톤 후기

허깅페이스 르로봇 해커톤 후기

본 블로그의 주인장들은 이번 허깅페이스의 르로봇 월드와이드 해커톤의 서울 호스트를 맡았습니다. 너무 재밌었고, 그 과정들과 후기를 남깁니다. 현장은 다큐 형식의 작은 영상을 만들었으니 한번 봐주세요. 계기 저는 LLM 만 하고 있었고, Action 모델은 사실 관심이 없었습니다, 준호는 1년 정도 로봇에 AI 를 넣는 일을 하고 있었죠. 허깅페이스에서 르로봇 플랫폼을 만들고

By park jong hyun
DeepDive LLM 3편 - Reinforcement Learning

DeepDive LLM 3편 - Reinforcement Learning

* 1편 - 사전 학습 (Pre Training) * 2편 - Supervised Fine Tuning * 3편 - Reinforcement Learning Reinforcement Learning Pretrain, SFT 에 이어서 세번째 단계는 Reinforcement Learning (RL, 강화학습) 입니다. 비유를 해보자면, pretrain은 그냥 책을 읽는 것이고요, SFT는 예제 문제와 이미 작성된 해설을 보는 것입니다. RL 은 해설이 없는 문제를 직접 풀어보는 것입니다. 어떻게 풀든

By park jong hyun
DeepDive LLM 2편 - Supervised Fine Tuning

DeepDive LLM 2편 - Supervised Fine Tuning

* 1편 - 사전 학습 (Pre Training) * 2편 - Supervised Fine Tuning * 3편 - 강화 학습 (Reinforcement Learning) Supervised Fine Tuning Post Training 의 첫번째 단계 SFT 입니다. Pre Training 에 비하면 아주 작은 양의 데이터만 필요하지만, 실제로 성능을 이끌어 내는데에는 중요한 단계입니다. 멀티턴 대화 (Multi Turn Conversation) ChatGPT 를 포함해서 대부분의 AI 서비스들은

By park jong hyun
DeepDive LLM 1편 - 사전 학습 (Pre-Training)

DeepDive LLM 1편 - 사전 학습 (Pre-Training)

본 포스트 시리즈는 카파시 선생님의 영상 을 기반으로 정리한 내용입니다. 직접 유투브에서 다루기도 했으니 영상으로 보셔도 됩니다. * 1편 - 사전 학습 (Pre-Training) * 2편 - Supervised Fine Tuning * 3편 - 강화 학습 (Reinforcement Learning) LLM 의 Training LLM을 만들 때는 크게 세 가지 주요 단계가 있습니다. 1. 사전 학습(Pre-Training) * 인터넷 텍스트(

By park jong hyun