KoGPT Web UI 만들기
이번 포스트는 kogpt.tmmse.xyz 를 만들면서 느낀 점들을 다룹니다.
(다 사용하고 현재는 닫았습니다. 사용하실 분들은 Github 코드를 빌드하시면 되는데, 이게 가능하시면 직접 만드시는게 더 편하실 거에요....)
KoGPT Rest API 공개
OpenAI 가 공개한 GPT-3 는 언어를 너무 잘 다뤄서 전세계가 놀랐었죠.
당연히 영어로 동작하기 때문에, 한국어를 잘 다루는 AI가 나오길 기대하고 있었습니다.
그리고 대략 2년쯤 지난 지금 역시나 한국어 버전이 나오기 시작합니다.
대표적으로는 네이버의 CLOVA와 카카오의 KoGPT 두 가지가 눈에 띕니다.
CLOVA는 현재 기업들만 사용신청이 가능합니다.
대신 뤼튼이라는 서비스가 CLOVA를 이용해서 서비스를 런칭했기 때문에 간접적으로 사용이 가능합니다.
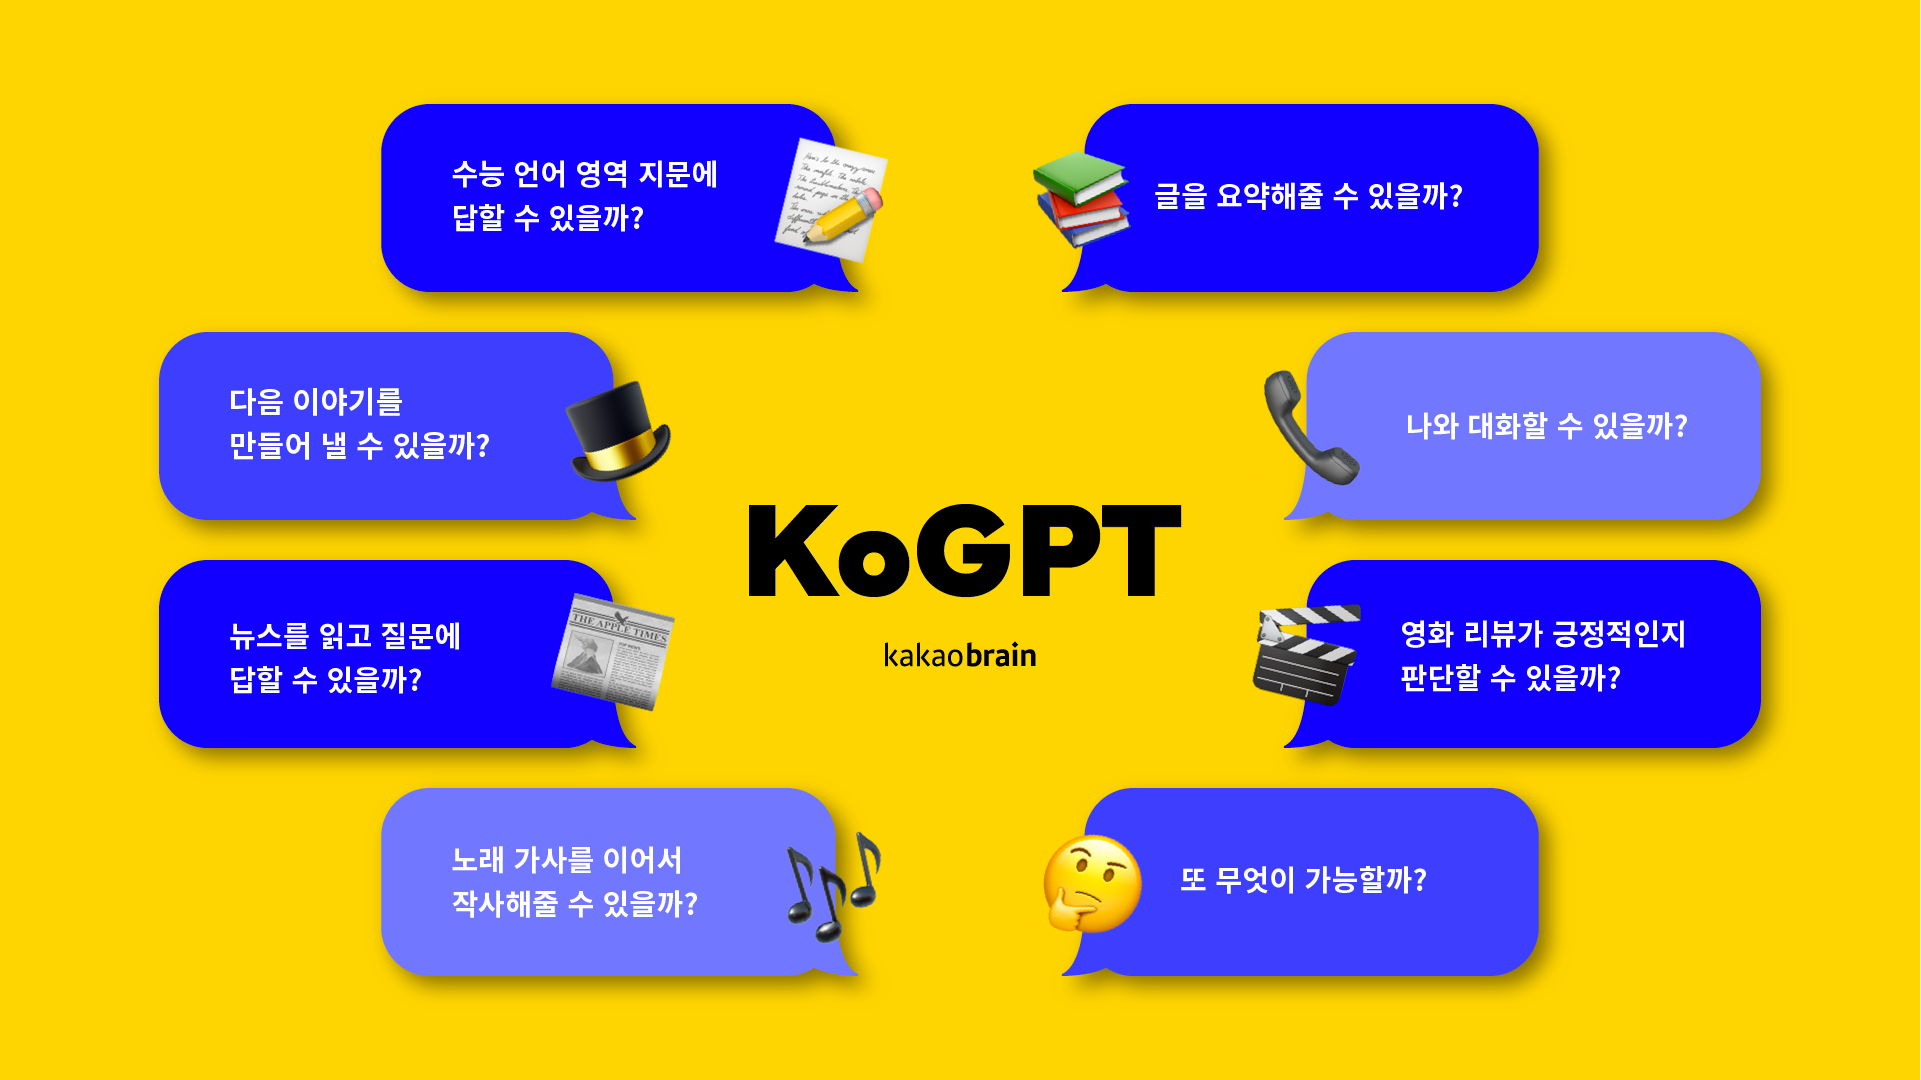
카카오에서 나온 KoGPT는 모델이 공개되어서 직접 돌려볼 수도 있습니다만, 비싼 장비를 갖췄거나, colab을 유료로 사용하는 등의 방법이 필요해서 어려움이 조금 있었죠.
이러던 와중에 최근 RESP API 로 KoGPT 를 사용할 수 있게 공개가 되었습니다! (Kakao 개발자 페이지)
보다 쉽게 사용이 가능해진 것인데요, 그래도 비전공자 분들은 바로 사용하기가 쉽지는 않습니다.
그래서 누구나 써볼 수 있게 만들었습니다.
(사실 여자친구 써보게 하려고 만들었어요.)
누구나 쉽게 사용할 수 있는 Interface
빠르게 배포할 수 있고, 누구나 접근이 가능하도록 Web으로 만들었습니다.
Kakao에서는 REST API 로만 공개를 했기 때문이죠.
개발자 분들은 REST API 쓰는 것이 어렵지 않겠지만, 컴퓨터를 다루지 않으신 분들은 쉽지 않아서 그냥 키보드/마우스만 있으면 쓸 수 있게 했습니다.
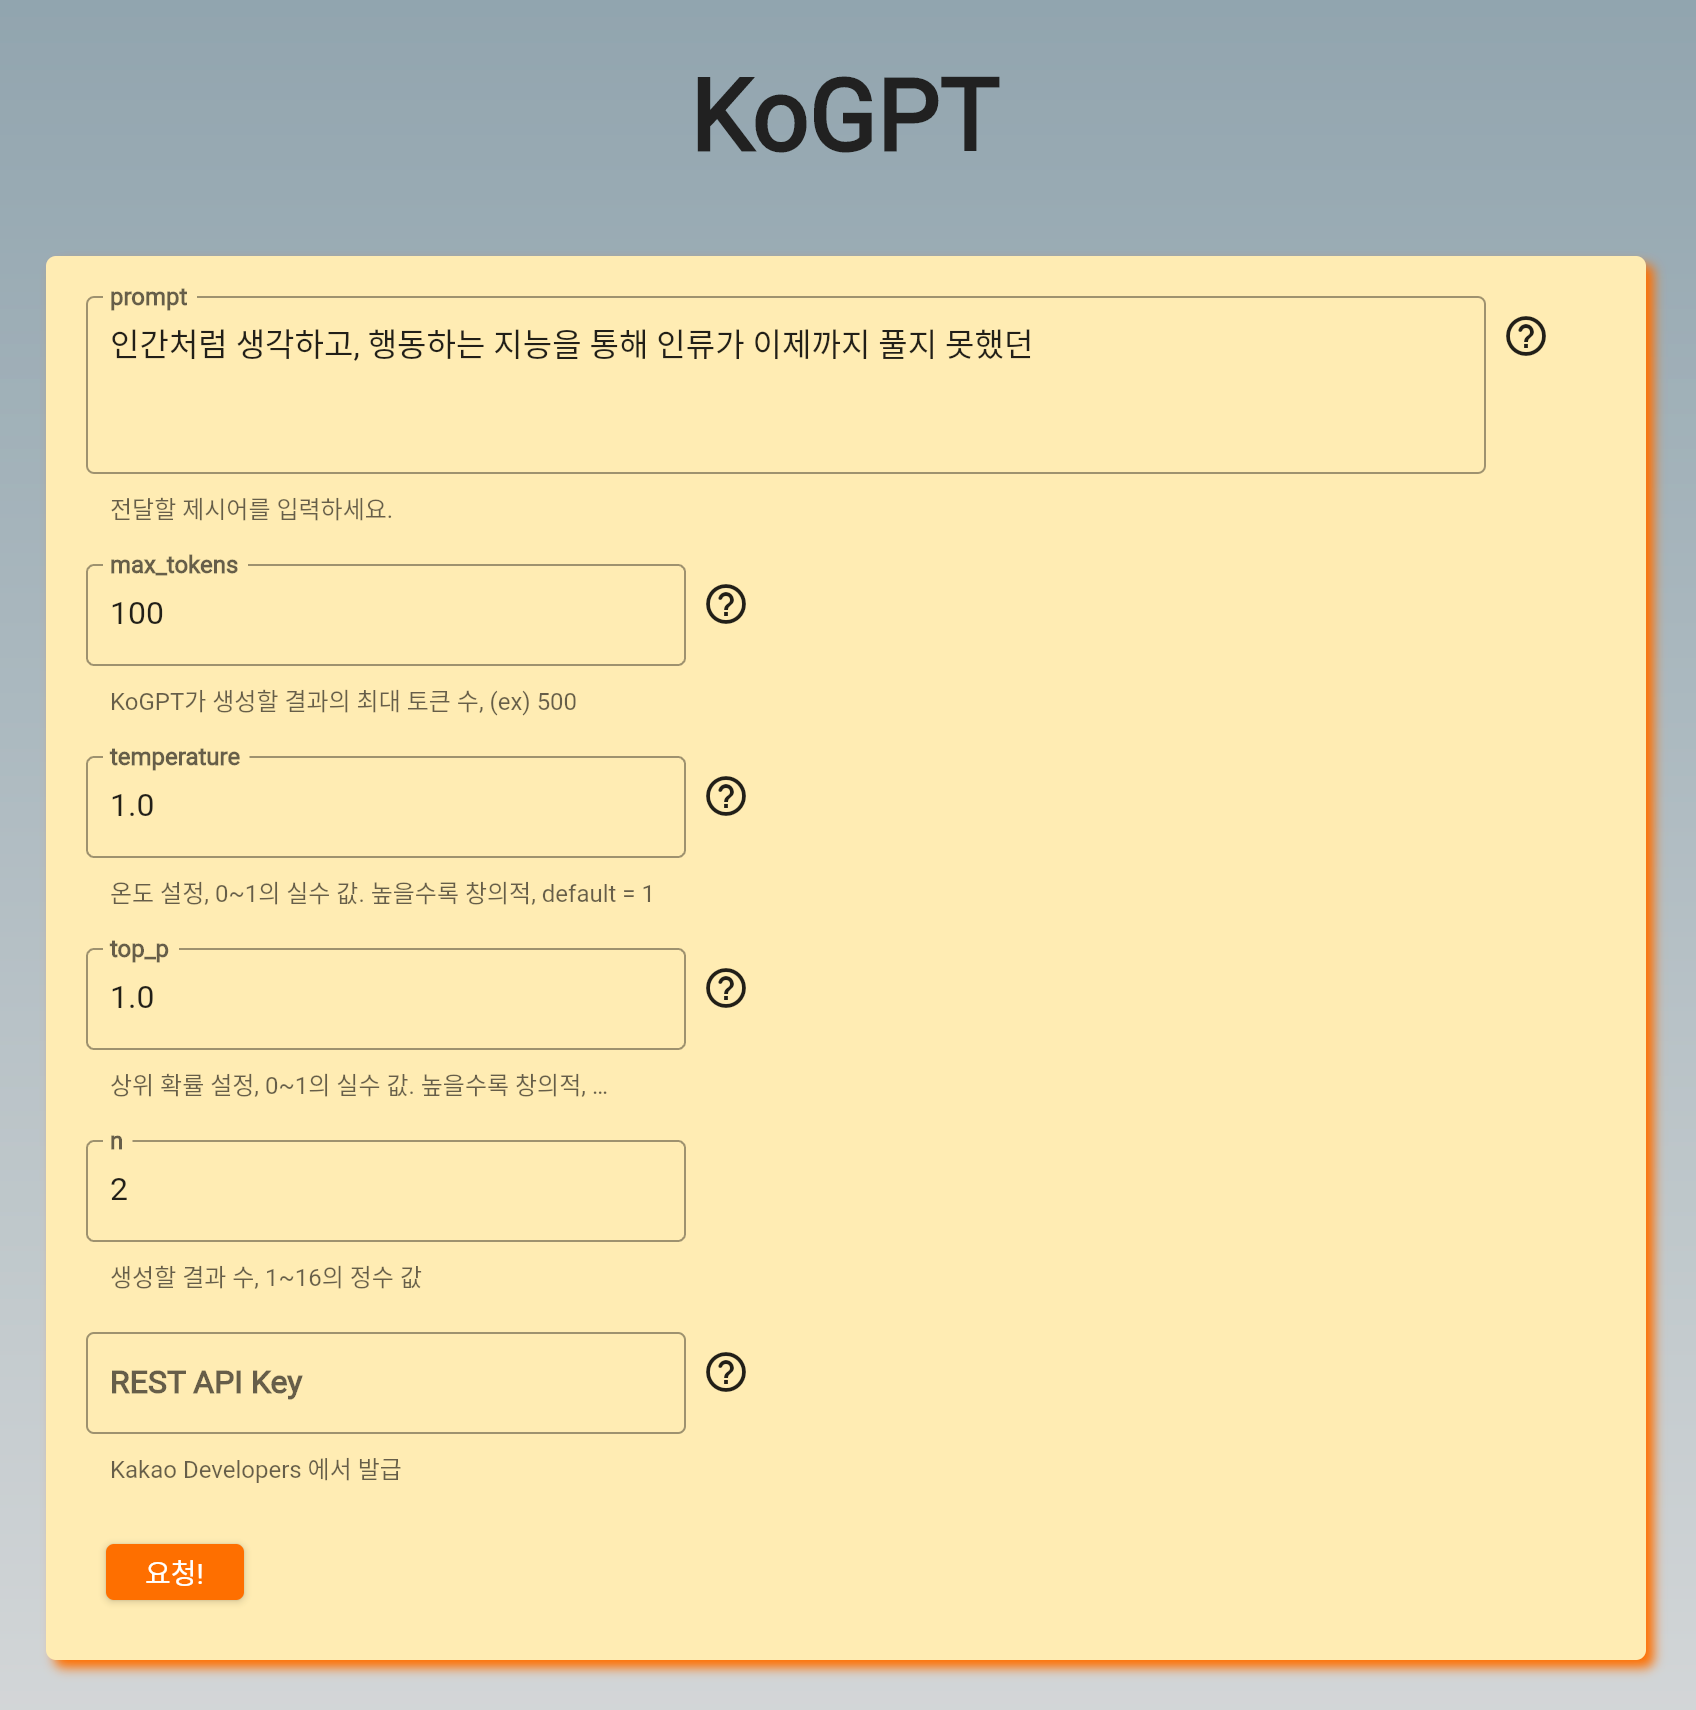
접속하시면 아래와 같은 화면이 나와서, 몇 가지만 입력하면 사용해보실 수 있습니다. 각 항목에 대한 설명은 공식 문서 링크를 걸어 뒀으니 가서 보셔야 합니다.
직접 써보는 내용은 영상으로 찍어보고 여기에 추가하려고 합니다.
후기
Framework는 Flutter를 사용했고, 코드는 Github 에 가시면 누구나 보실 수 있습니다.
디자인은 뭐... 그냥 대충 구현 빨리 되는대로 했습니다.
1차로 다 만들고 나니 너무 안예쁘네요. 기회가되면 개선해볼까 싶습니다.
구현하는데 대충 5~6시간 정도 걸린 것 같네요.
Firebase 에 호스팅하고, 블로그 서브도메인 연결하고, 배포하고 하니 대략 8시간 정도 소요되었습니다.
Flutter와 Firebase를 사용한 이유는 그냥 제가 익숙해서이고, 혹시 앱으로 출시할 수도 있으니, cross-platform이 지원되는 프레임워크가 유리하기도 합니다.
이런 Web 페이지는 제가 처음 만들어보는데, 워낙 간단한 기능이다 보니 크게 어려움은 없었네요.
사실 이 앱의 본질은 그냥 REST API를 호출하고, 결과를 뿌려주는 것이 끝입니다.
그래서, 나중에 다양한 REST API 를 대응 할 수 있도록 고민을 살짝 해봤습니다.
자유도와 가독성을 둘 다 챙기고 싶었는데, 모두 만족시키는 것이 어렵네요.
나중에 다른 사람들이 잘 짠 코드를 참고해 봐야겠다는 생각이 들었습니다.
스스로 판단하기에 제가 간단하게 만든 코드가 만족스럽지는 못하네요.