pix2pix : Image Translation with GAN (2)

Share
pix2pix : Image Translation with GAN (2)
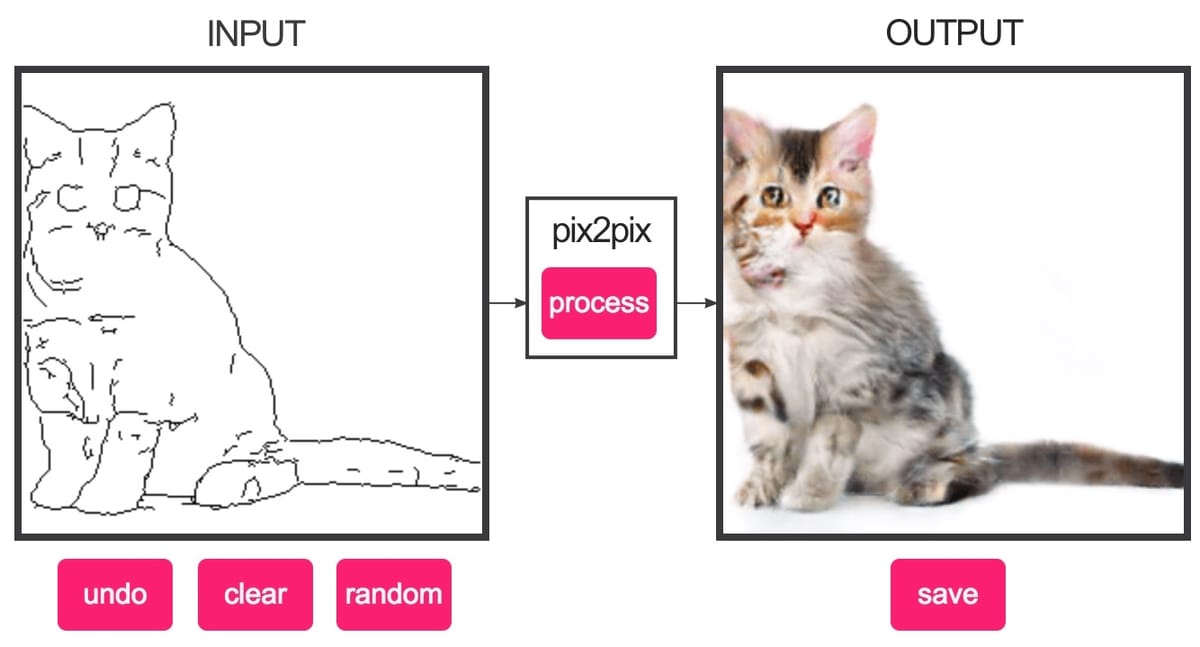
Image-to-Image Translation with Conditional Adversarial Networks (pix2pix)

published to CVPR2017 by Phillip Isola, Jun-Yan Zhu, Tinghui Zhou, Alexei A. Efros
fit
inline
inline

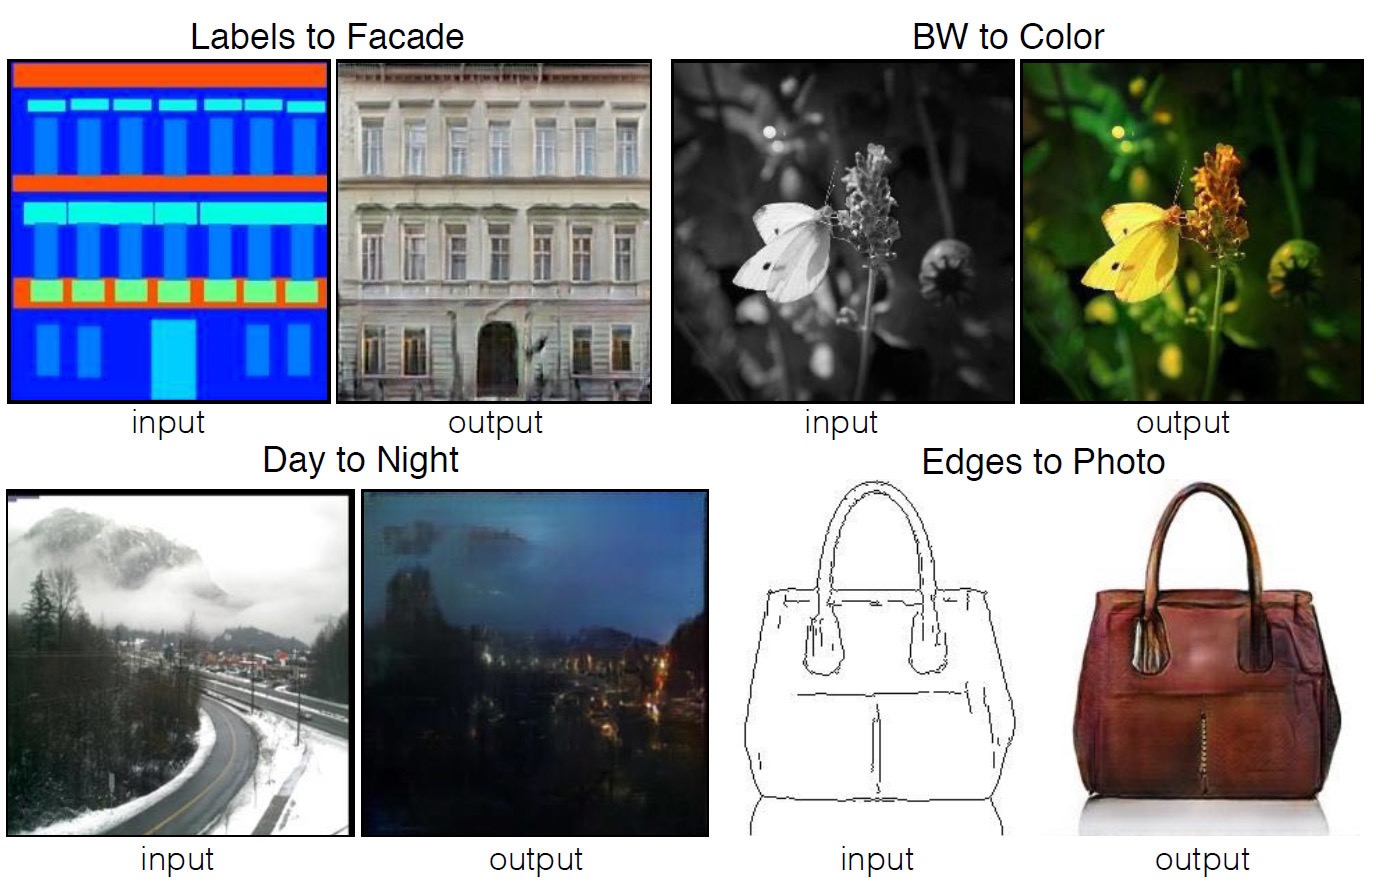
Learn pair-wise images of $S$ and $T$ like below

  • BW & Color image
  • Street Scene & Label
  • Facade & Label
  • Aerial & Map
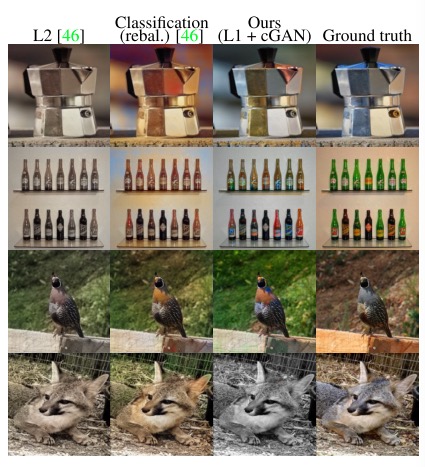
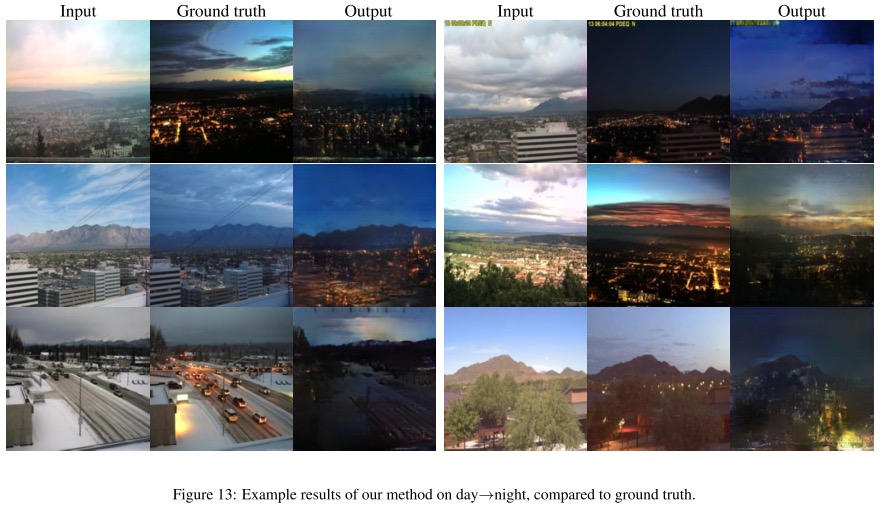
  • Day & Night
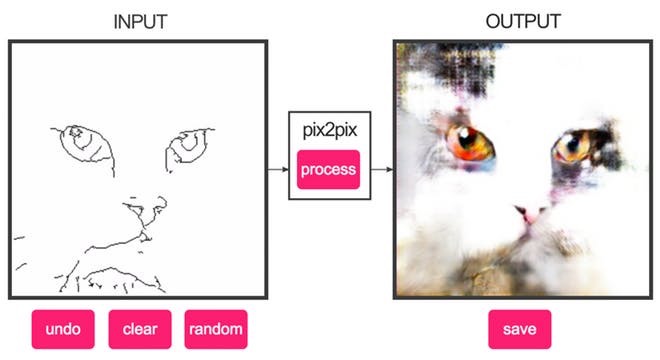
  • Edges & Photo

source image $x \in S$, target image (label) $y \in T$ is pair-wise.

thus it is Supervised Learning

Generator of pix2pix

$G(x,z)$ where $x$: image and $z$: noise
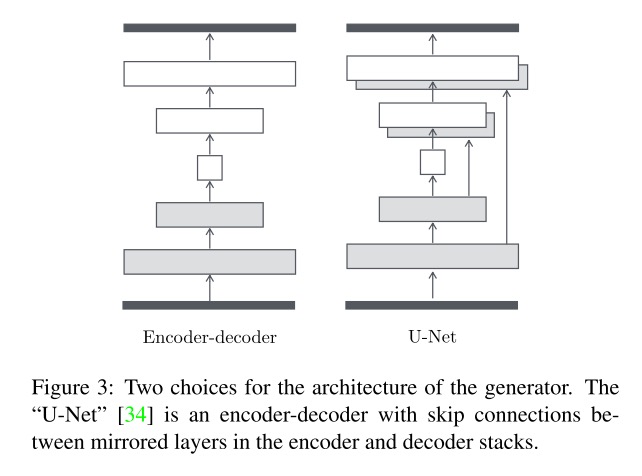
left fit
Use U-Net shaped network

  • known to be powerful at segmentation task
  • use spatial information from features of bottom layer
  • use dropout as noise in decoder part

Discriminator of pix2pix
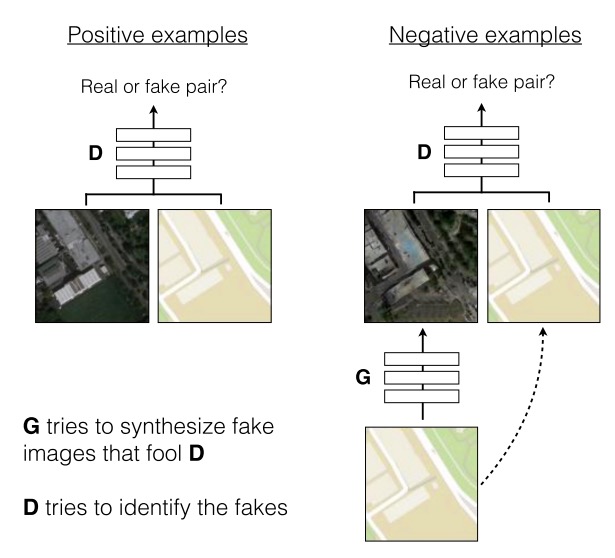
inline

Loss function

inline 40%
$x$: source image, $y$: target image, $z$: noise

Use Adversarial loss and L1 loss

\begin{equation}
\mathcal{L}_{cGAN}(G,D) = \mathbb{E}_{x,y \sim p_{data}(x,y)}[\log D(x,y)] + \mathbb{E}_{x \sim p_{data}(x), z \sim p_z(z)}[\log (1-D(x,G(x,z)))]
\end{equation}

\begin{equation}
\mathcal{L}_{L1}(G) = \mathbb{E}_{x,y \sim p_{data}(x,y),z \sim p_z(z)}[||y-G(x,z)||_1]
\end{equation}

Result
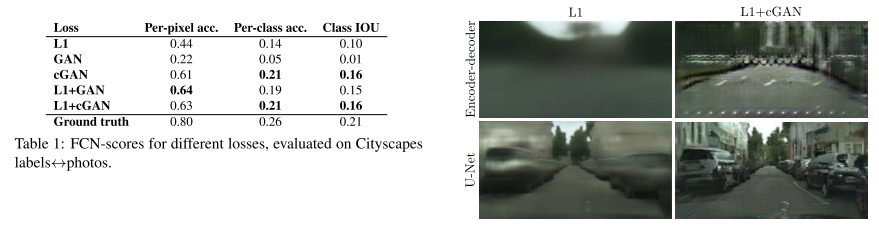
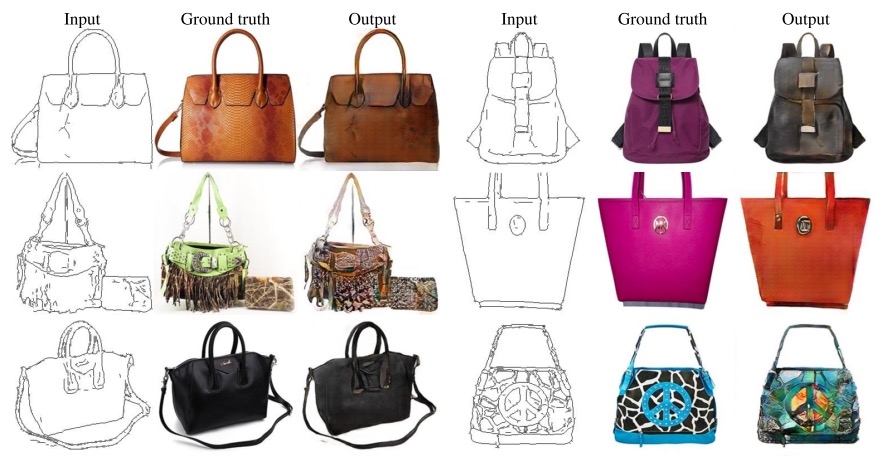
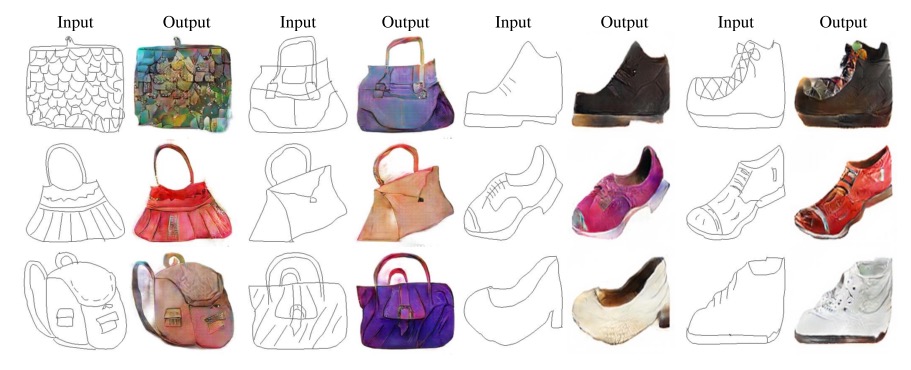
inline
fit
fit
fit
fit
fit
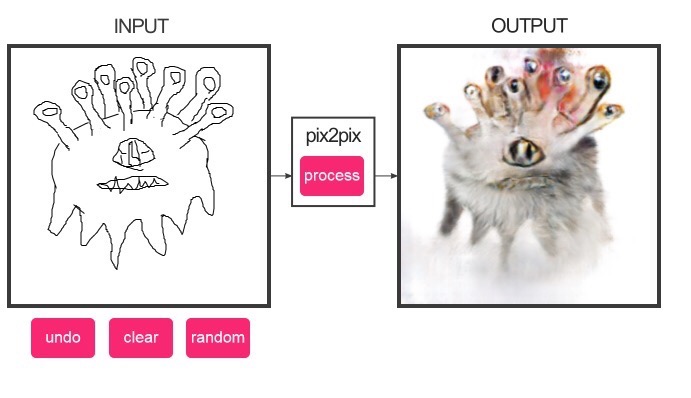
Do demo!
https://affinelayer.com/pixsrv/

Read more

허깅페이스 르로봇 해커톤 후기

허깅페이스 르로봇 해커톤 후기

본 블로그의 주인장들은 이번 허깅페이스의 르로봇 월드와이드 해커톤의 서울 호스트를 맡았습니다. 너무 재밌었고, 그 과정들과 후기를 남깁니다. 현장은 다큐 형식의 작은 영상을 만들었으니 한번 봐주세요. 계기 저는 LLM 만 하고 있었고, Action 모델은 사실 관심이 없었습니다, 준호는 1년 정도 로봇에 AI 를 넣는 일을 하고 있었죠. 허깅페이스에서 르로봇 플랫폼을 만들고

By park jong hyun
DeepDive LLM 3편 - Reinforcement Learning

DeepDive LLM 3편 - Reinforcement Learning

* 1편 - 사전 학습 (Pre Training) * 2편 - Supervised Fine Tuning * 3편 - Reinforcement Learning Reinforcement Learning Pretrain, SFT 에 이어서 세번째 단계는 Reinforcement Learning (RL, 강화학습) 입니다. 비유를 해보자면, pretrain은 그냥 책을 읽는 것이고요, SFT는 예제 문제와 이미 작성된 해설을 보는 것입니다. RL 은 해설이 없는 문제를 직접 풀어보는 것입니다. 어떻게 풀든

By park jong hyun
DeepDive LLM 2편 - Supervised Fine Tuning

DeepDive LLM 2편 - Supervised Fine Tuning

* 1편 - 사전 학습 (Pre Training) * 2편 - Supervised Fine Tuning * 3편 - 강화 학습 (Reinforcement Learning) Supervised Fine Tuning Post Training 의 첫번째 단계 SFT 입니다. Pre Training 에 비하면 아주 작은 양의 데이터만 필요하지만, 실제로 성능을 이끌어 내는데에는 중요한 단계입니다. 멀티턴 대화 (Multi Turn Conversation) ChatGPT 를 포함해서 대부분의 AI 서비스들은

By park jong hyun
DeepDive LLM 1편 - 사전 학습 (Pre-Training)

DeepDive LLM 1편 - 사전 학습 (Pre-Training)

본 포스트 시리즈는 카파시 선생님의 영상 을 기반으로 정리한 내용입니다. 직접 유투브에서 다루기도 했으니 영상으로 보셔도 됩니다. * 1편 - 사전 학습 (Pre-Training) * 2편 - Supervised Fine Tuning * 3편 - 강화 학습 (Reinforcement Learning) LLM 의 Training LLM을 만들 때는 크게 세 가지 주요 단계가 있습니다. 1. 사전 학습(Pre-Training) * 인터넷 텍스트(

By park jong hyun