맥(macOS)에서 Adobe 제품들의 수동 업데이트

Share

OSX가 macOS로 Sierra으로 바뀌면서 낡은 정보일 수 있습니다.


Illustrator 2014CC로 작업을 하는데, 더블/트리플 모니터 등에서 우클릭이 안되는 버그가 있다. 이를 해결하기 위해서는 패치를 해야한다고한다.

근데 Creative App 자동업데이트 어쩌구저쩌구는하면 되는데, 내가 받은 Illustrators는 서울대 SW라 불가능한댄다.

이것을 해결하기 위해서 수동업데이트를 검색으로 [이곳](이곳에서 에서 받았다.

그럼에도 불구하고

관리자 어쩌구 저쩌구

이 블로그를 통해서 문제를 해결하였다.
Read more

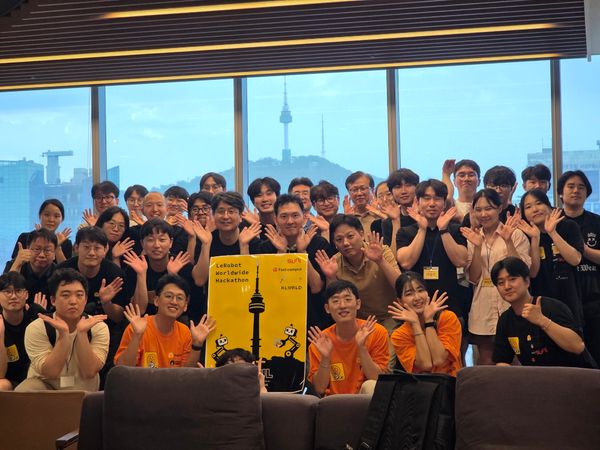
허깅페이스 르로봇 해커톤 후기

허깅페이스 르로봇 해커톤 후기

본 블로그의 주인장들은 이번 허깅페이스의 르로봇 월드와이드 해커톤의 서울 호스트를 맡았습니다. 너무 재밌었고, 그 과정들과 후기를 남깁니다. 현장은 다큐 형식의 작은 영상을 만들었으니 한번 봐주세요. 계기 저는 LLM 만 하고 있었고, Action 모델은 사실 관심이 없었습니다, 준호는 1년 정도 로봇에 AI 를 넣는 일을 하고 있었죠. 허깅페이스에서 르로봇 플랫폼을 만들고

By park jong hyun
DeepDive LLM 3편 - Reinforcement Learning

DeepDive LLM 3편 - Reinforcement Learning

* 1편 - 사전 학습 (Pre Training) * 2편 - Supervised Fine Tuning * 3편 - Reinforcement Learning Reinforcement Learning Pretrain, SFT 에 이어서 세번째 단계는 Reinforcement Learning (RL, 강화학습) 입니다. 비유를 해보자면, pretrain은 그냥 책을 읽는 것이고요, SFT는 예제 문제와 이미 작성된 해설을 보는 것입니다. RL 은 해설이 없는 문제를 직접 풀어보는 것입니다. 어떻게 풀든

By park jong hyun
DeepDive LLM 2편 - Supervised Fine Tuning

DeepDive LLM 2편 - Supervised Fine Tuning

* 1편 - 사전 학습 (Pre Training) * 2편 - Supervised Fine Tuning * 3편 - 강화 학습 (Reinforcement Learning) Supervised Fine Tuning Post Training 의 첫번째 단계 SFT 입니다. Pre Training 에 비하면 아주 작은 양의 데이터만 필요하지만, 실제로 성능을 이끌어 내는데에는 중요한 단계입니다. 멀티턴 대화 (Multi Turn Conversation) ChatGPT 를 포함해서 대부분의 AI 서비스들은

By park jong hyun
DeepDive LLM 1편 - 사전 학습 (Pre-Training)

DeepDive LLM 1편 - 사전 학습 (Pre-Training)

본 포스트 시리즈는 카파시 선생님의 영상 을 기반으로 정리한 내용입니다. 직접 유투브에서 다루기도 했으니 영상으로 보셔도 됩니다. * 1편 - 사전 학습 (Pre-Training) * 2편 - Supervised Fine Tuning * 3편 - 강화 학습 (Reinforcement Learning) LLM 의 Training LLM을 만들 때는 크게 세 가지 주요 단계가 있습니다. 1. 사전 학습(Pre-Training) * 인터넷 텍스트(

By park jong hyun