CUDA Memory Model

Share
CUDA Memory Model

CUDA 프로그램은 같은 일을 하더라도 구현 방식(알고리즘)에 따라 천차만별의 성능을 보인다.
그 중 Memory Model를 모르면 정말 프로그램이 한참 느려진다.

CUDA Memory Model

이를 위해 가장 먼저 알아야 하는 것이 memory model 이다.
CUDA 에는 여러가지 사용할 수 있는 여러가지 메모리가 있다.
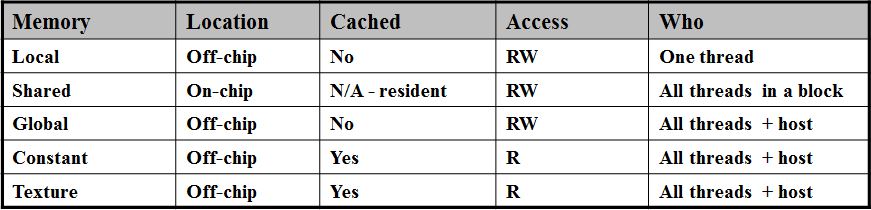
가장 중요한 것은 global memory 와 shared memory.
참고로, 위의 표에는 constant memory 와 texture memory 가 off-chip에 있다고 되어있지만 옛날꺼는 그렇고 요즘꺼는 on-chip 에 있다. - architecture 별 whitepaper 참조에서 확인해 볼 것)

Shared Memory

Shared Memory 는 CUDA 에서 제공하는 scratchpad memory로 프로그래머가 직접 데이터를 올려둘 수 있는 공간이다.
Shared memory 는 한 thread block 내의 thread 들 끼리 공유하는 영역이라 통신이 가능하고, SM (Streaming Multiprocessor) 안에 있기 때문에 빠르다.
실제로 L1 cache 와 물리적으로 같은 위치(거리?)에 위치해 있어서, 읽는 데에 10 cycle 내로 걸린다. (cache 에서 miss가 난 경우 보통 memory 까지 가면 수백 cycle이 걸린다고 한다.)

사용 방법

사용방법은 아주 간단하다.
CUDA 커널 내에 아래와 같이 변수가 선언되어있다면,

float data[64][64]

다음과 같이 _shared_ 를 붙여주기만 하면 된다.

__shared__ float data[64][64]

주의할 점은 thread block 밖의 thread 끼리는 변수를 공유 할 수 없다.
그리고, 물리적인 크기가 Fermi architecture (ex. GTX480) 기준으로 48KB를 넘어갈 수 없다.

속도는 무진장 빨라진다.
내가 직접 실험해본 바에 의하면 Neural Net 코드를 돌려보았는데, 저것만으로 속도가 2배가 차이가 난다.

Read more

허깅페이스 르로봇 해커톤 후기

허깅페이스 르로봇 해커톤 후기

본 블로그의 주인장들은 이번 허깅페이스의 르로봇 월드와이드 해커톤의 서울 호스트를 맡았습니다. 너무 재밌었고, 그 과정들과 후기를 남깁니다. 현장은 다큐 형식의 작은 영상을 만들었으니 한번 봐주세요. 계기 저는 LLM 만 하고 있었고, Action 모델은 사실 관심이 없었습니다, 준호는 1년 정도 로봇에 AI 를 넣는 일을 하고 있었죠. 허깅페이스에서 르로봇 플랫폼을 만들고

By park jong hyun
DeepDive LLM 3편 - Reinforcement Learning

DeepDive LLM 3편 - Reinforcement Learning

* 1편 - 사전 학습 (Pre Training) * 2편 - Supervised Fine Tuning * 3편 - Reinforcement Learning Reinforcement Learning Pretrain, SFT 에 이어서 세번째 단계는 Reinforcement Learning (RL, 강화학습) 입니다. 비유를 해보자면, pretrain은 그냥 책을 읽는 것이고요, SFT는 예제 문제와 이미 작성된 해설을 보는 것입니다. RL 은 해설이 없는 문제를 직접 풀어보는 것입니다. 어떻게 풀든

By park jong hyun
DeepDive LLM 2편 - Supervised Fine Tuning

DeepDive LLM 2편 - Supervised Fine Tuning

* 1편 - 사전 학습 (Pre Training) * 2편 - Supervised Fine Tuning * 3편 - 강화 학습 (Reinforcement Learning) Supervised Fine Tuning Post Training 의 첫번째 단계 SFT 입니다. Pre Training 에 비하면 아주 작은 양의 데이터만 필요하지만, 실제로 성능을 이끌어 내는데에는 중요한 단계입니다. 멀티턴 대화 (Multi Turn Conversation) ChatGPT 를 포함해서 대부분의 AI 서비스들은

By park jong hyun
DeepDive LLM 1편 - 사전 학습 (Pre-Training)

DeepDive LLM 1편 - 사전 학습 (Pre-Training)

본 포스트 시리즈는 카파시 선생님의 영상 을 기반으로 정리한 내용입니다. 직접 유투브에서 다루기도 했으니 영상으로 보셔도 됩니다. * 1편 - 사전 학습 (Pre-Training) * 2편 - Supervised Fine Tuning * 3편 - 강화 학습 (Reinforcement Learning) LLM 의 Training LLM을 만들 때는 크게 세 가지 주요 단계가 있습니다. 1. 사전 학습(Pre-Training) * 인터넷 텍스트(

By park jong hyun