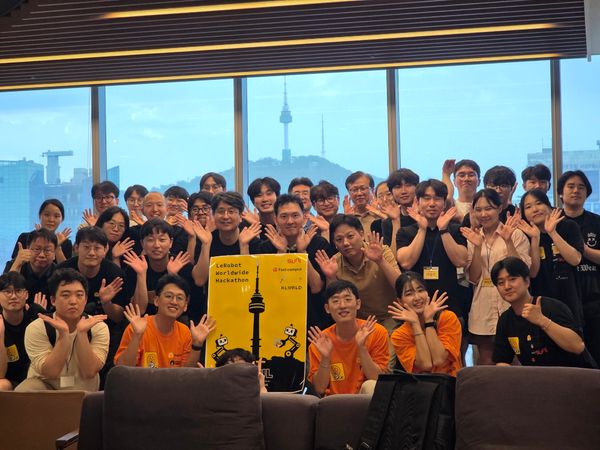
허깅페이스 르로봇 해커톤 후기
본 블로그의 주인장들은 이번 허깅페이스의 르로봇 월드와이드 해커톤의 서울 호스트를 맡았습니다. 너무 재밌었고, 그 과정들과 후기를 남깁니다. 현장은 다큐 형식의 작은 영상을 만들었으니 한번 봐주세요. 계기 저는 LLM 만 하고 있었고, Action 모델은 사실 관심이 없었습니다, 준호는 1년 정도 로봇에 AI 를 넣는 일을 하고 있었죠. 허깅페이스에서 르로봇 플랫폼을 만들고

본 블로그의 주인장들은 이번 허깅페이스의 르로봇 월드와이드 해커톤의 서울 호스트를 맡았습니다. 너무 재밌었고, 그 과정들과 후기를 남깁니다. 현장은 다큐 형식의 작은 영상을 만들었으니 한번 봐주세요. 계기 저는 LLM 만 하고 있었고, Action 모델은 사실 관심이 없었습니다, 준호는 1년 정도 로봇에 AI 를 넣는 일을 하고 있었죠. 허깅페이스에서 르로봇 플랫폼을 만들고

* 1편 - 사전 학습 (Pre Training) * 2편 - Supervised Fine Tuning * 3편 - Reinforcement Learning Reinforcement Learning Pretrain, SFT 에 이어서 세번째 단계는 Reinforcement Learning (RL, 강화학습) 입니다. 비유를 해보자면, pretrain은 그냥 책을 읽는 것이고요, SFT는 예제 문제와 이미 작성된 해설을 보는 것입니다. RL 은 해설이 없는 문제를 직접 풀어보는 것입니다. 어떻게 풀든

* 1편 - 사전 학습 (Pre Training) * 2편 - Supervised Fine Tuning * 3편 - 강화 학습 (Reinforcement Learning) Supervised Fine Tuning Post Training 의 첫번째 단계 SFT 입니다. Pre Training 에 비하면 아주 작은 양의 데이터만 필요하지만, 실제로 성능을 이끌어 내는데에는 중요한 단계입니다. 멀티턴 대화 (Multi Turn Conversation) ChatGPT 를 포함해서 대부분의 AI 서비스들은

본 포스트 시리즈는 카파시 선생님의 영상 을 기반으로 정리한 내용입니다. 직접 유투브에서 다루기도 했으니 영상으로 보셔도 됩니다. * 1편 - 사전 학습 (Pre-Training) * 2편 - Supervised Fine Tuning * 3편 - 강화 학습 (Reinforcement Learning) LLM 의 Training LLM을 만들 때는 크게 세 가지 주요 단계가 있습니다. 1. 사전 학습(Pre-Training) * 인터넷 텍스트(

24년 12월 OpenAI 의 추론 (Reasoning) 모델 o1 은 이미지를 인풋으로 받을 수 있게 되어 멀티모달 모델이 되었습니다. 기존 GPT-4o 를 기반으로 만든 멀티모달 RAG 시스템이 있는데요, o1 으로 교체를 하면서 얼마나 똑똑해 졌는지, 비용은 얼마나 나올지 한번 해보겠습니다. (+ 약간의 개선 작업도) ESG 분석기 시스템 개요 목표는 간단합니다. 대부분의

요즘 많은 매체 (기사, 유투브, 포스트) 에서 "AI Agent가 미래다" 라는 말을 많이 합니다. 대표적으로 Andrew Ng 선생님께서 1년 넘게 Agent에 대해 이야기 하고 계시죠. 그런데, "Agent" 라는 키워드에 대한 정의가 많이 다르고 본인들 유리할대로 사용하는 경우가 많더라고요. 올해 (24년) Agent를 직접 구현하여 시스템을 만드는 강의를

최근 LangSmith (랭스미스) 를 RAG 시스템 개발/운영에 아주 유용하게 쓰고 있습니다. 동시에 SKT 에서 Langsmith 의 사용에 대한 강의도 진행했습니다. 그 내용은 책으로도 발간을 준비하고 있는데, 사용해보면서 느낀 점들을 정리해보겠습니다. LangSmith COURSE!LangSmith의 사용법, 컨셉, 주요 기능을 소개합니다. 한 줄 요약: 꼭 쓰세요! 두 번 쓰세요! 대체 솔루션 많으니

본 포스트는 코드 구현이나 테크니컬 디테일 보다는 ChatGPT를 필두로한 새로운 생성형AI 모델들로 인해 나타날 변화에 대해 사유합니다. 저는 주로 현직 엔지니어나 개발자분들을 대상으로 강의를 하기 때문에, LLM 또는 Transformer 의 원리나 실제 코드로 시스템을 구축하는 방법 등을 다룹니다. 그러던 24년 4월, 우연한 기회로 서울대학교 현대사회와 미디어 강의에서 생성형AI 관련 특강을

최근에 딥러닝 기반 서비스를 바닥부터 다 만든 일이 있었다. 만들고 시범 운영을 해보면서 느낀 점, 구현하면서 생각해 볼 만한 점들을 정리해보았다. 문제 정의 차량의 주행 및 소음진동 정보를 기반으로 차량의 상태를 진단하자. 이번에 딥러닝 모델을 도입해서 풀고자 하는 문제는 특정 부품의 내구 상태를 알아내는 것이다. 💡Input : 소음, 진동, 차속, RPM,

딥러닝 강의를 다시 하게 되어서, 좋은 자료들을 정리하려고 찾아다니다가 certificate 들이 눈에 들어와서 땄다. 취득 한 것은 NVIDIA와 Tensorflow 에서 발급하는 두 가지 인데, 따면서 느꼈던? 알게된? 점들을 정리하겠다. NVIDIA NVIDIA 에는 많은 교육과정들이 잘 정리되어 있는데, 딥러닝 관련 코스들만 해도 꽤 10개 넘는 과정들이 있다. NVIDIA Deep Learning Self-
매일매일 LLM 관련 새로운 발표들이 쏟아져 나오고 있다. 이미 ChatGPT 는 전 국민이 아는 단어이고, 많은 사람들이 사용하고 있다. (당연히 나도 결제해서 유료 모델인 GPT4를 매우 유용하게 사용하고 있다.) 그럼 나는 이걸 이용해서 뭘 할 수 있을까? 작금의 LLM은 한계가 어디까지이고 잠재력은 어디까지일까? 직접 사용해 보고 느껴보자. (LLM 은 GPT를

본 포스트는 DB & Auth 개발을 하며 삽질한 내용을 다룹니다 계기 필자는 혼자서 서비스를 개발하고 있었습니다. 개발자 관점에서는 본 서비스는 다음과 같이 간단합니다. 사용자는 로그인을 하고, 돈을 낸 만큼 데이터를 열람할 수 있습니다. 저는 serverless로 scalable하고 보안적으로 문제가 없게 구현하고 싶었습니다. 백엔드를 만들고 운영하면서 계정관리도하고 데이터베이스 접근도 다 검사하는 무식한